Reparación de Servidores en Málaga
Diagnóstico y reparación de hardware, almacenamiento, sistemas y virtualización con atención a los datos y la continuidad de la empresa.
Recuperar el servicio sin poner en riesgo los datos
Un servidor puede concentrar archivos, aplicaciones, usuarios, copias, máquinas virtuales y servicios esenciales para una empresa. Por eso la reparación de servidores requiere valorar primero qué está fallando y qué operaciones pueden realizarse sin comprometer la información.
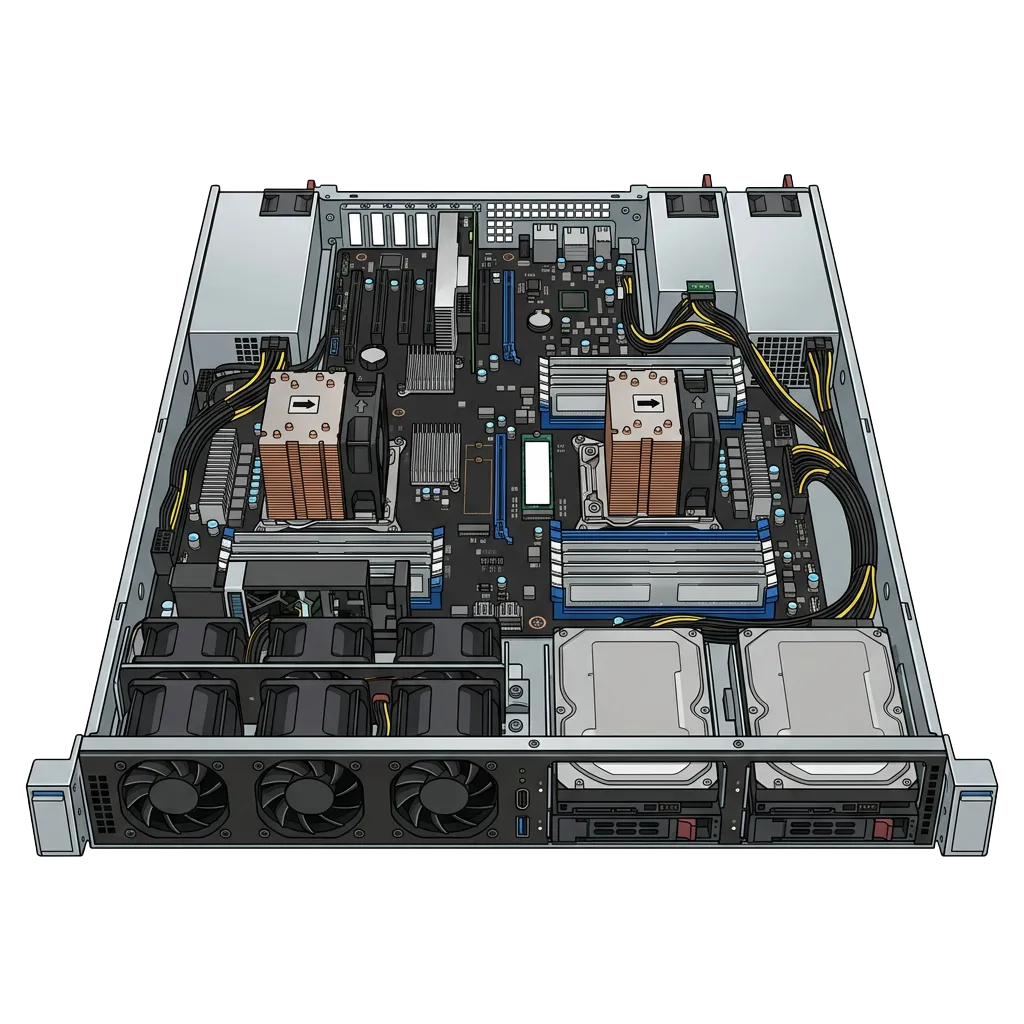
En Satempresas revisamos servidores físicos y sus servicios asociados, almacenamiento, RAID, memoria, alimentación, temperatura, red y sistema operativo. Cuando existe riesgo para los datos, la prioridad es preservar el almacenamiento antes de intentar reconstrucciones o reinstalaciones.
La prioridad es recuperar el servicio sin empeorar la avería. Un servidor puede alojar ficheros, usuarios, aplicaciones, bases de datos o máquinas virtuales: antes de reiniciarlo, sustituir piezas o reconstruir volúmenes, es necesario conocer esas dependencias y el estado real de las copias disponibles.
Primero: alcance de la incidencia
Antes de intervenir identificamos qué servicios están afectados, cuándo comenzó el problema, si hubo cambios recientes y qué copias existen. No es lo mismo un fallo de fuente redundante que un RAID degradado o un sistema operativo que no inicia.
Esta información permite decidir si conviene reparar en el propio sistema, aislar discos, restaurar desde backup o preparar una solución temporal.
Recogemos los síntomas, mensajes de controladora, alertas de hardware, cambios recientes y hora de aparición. Es importante saber si fallan todos los servicios o solo una aplicación, y si el equipo está apagado o simplemente inaccesible por la red.
Si existe sospecha de fallo de almacenamiento, evitamos reinicios y operaciones de escritura innecesarias hasta valorar los riesgos. La estrategia cambia según el servidor tenga redundancia, backup verificable o discos con errores simultáneos.
Almacenamiento y RAID
Un RAID degradado requiere prudencia. Sustituir un disco incorrecto, forzar una reconstrucción sobre unidades inestables o inicializar una controladora puede agravar la pérdida. Comprobamos la topología y el estado de los soportes antes de actuar.
Si los datos ya no son accesibles, el caso puede pasar a recuperación de datos RAID. Y recordamos una regla fundamental: RAID mejora disponibilidad, pero no es una copia de seguridad.
Antes de sustituir discos se identifican ranuras, números de serie, estado de cada unidad, nivel RAID, configuración de la controladora y alertas registradas. No inicializamos volúmenes para «probar» si los datos todavía pueden recuperarse.
Advertencia: una reconstrucción RAID es una operación intensiva que puede agravar problemas en otros discos. Si hay varios soportes deteriorados, puede ser preferible preservar su estado y evaluar recuperación especializada antes de intervenir.
Fuentes, memoria y temperatura
Fuentes redundantes, memoria ECC, ventiladores y sensores están diseñados para mejorar la disponibilidad, pero también fallan. Revisamos alertas de hardware, eventos, temperaturas y estabilidad. Un servidor con ventilación deficiente puede seguir funcionando mientras degrada discos y componentes.
Comprobamos indicadores, fuentes, módulos de memoria, estado de ventiladores, control de temperatura y registros de gestión cuando estén disponibles. Una fuente redundante protege frente a determinados fallos, pero no cubre todos los escenarios de alimentación.
El diagnóstico contempla también SAI/UPS, polvo, flujo de aire, consumo y condiciones de la sala. No se sustituye una placa base solo porque el servidor se haya reiniciado: primero se contrastan pruebas y registros.
Windows Server, Linux y servicios
Cuando el hardware está estable, analizamos arranque, sistema de archivos, servicios, red y eventos. En entornos Windows o Linux la incidencia puede estar en el propio sistema, una actualización, permisos, almacenamiento o configuración de red.
La reparación debe centrarse en recuperar el servicio con el menor cambio posible y documentar después lo realizado.
Analizamos inicio del sistema, errores de disco, servicios de directorio, permisos, DNS, tareas programadas y aplicaciones esenciales en la medida en que formen parte de la incidencia. Una caída aparente puede provenir de la red, de una actualización o de un servicio detenido.
Si procede restaurar o migrar, se identifican licencias, roles, dependencias y configuración previa. La reparación busca devolver la funcionalidad y verificarla con usuarios o responsables, no limitarse a que el sistema arranque.
Virtualización
En servidores virtualizados distinguimos entre el problema del host y el de las máquinas virtuales. Espacio agotado, snapshots acumulados, almacenamiento lento o fallos del host pueden afectar a varias máquinas simultáneamente. Antes de manipular discos virtuales comprobamos su ubicación y las copias disponibles.
En Hyper-V, VMware, Proxmox u otros entornos comprobamos recursos del host, espacio de datastore, estado de máquinas virtuales, snapshots y copias. Un snapshot no debe confundirse con una copia independiente; mantener cadenas largas también puede introducir riesgos operativos.
Antes de mover discos virtuales o cambiar almacenamiento se documenta la configuración y se valora el impacto sobre las máquinas invitadas. El proceso depende de la versión, licencias y arquitectura existente.
Red y acceso
Un servidor aparentemente caído puede estar operativo pero inaccesible por un fallo de switch, VLAN, DNS, direccionamiento o interfaz de red. Por eso la revisión se coordina, cuando procede, con nuestra área de redes informáticas.
Comprobamos conectividad del host, interfaces, switches, VLAN, DNS y servicios de red antes de concluir que el servidor está averiado. Una pérdida de resolución de nombres o un puerto mal configurado puede dejar a usuarios sin acceso aunque el equipo esté operativo.
Esta comprobación se coordina con el servicio de redes empresariales cuando la incidencia afecta a otras máquinas o sedes.
Después de reparar: evitar la siguiente parada
Una incidencia crítica es un buen momento para revisar monitorización, copias, capacidad, estado del RAID, UPS, actualizaciones y documentación. Nuestro servicio de mantenimiento informático permite convertir una reparación puntual en un plan preventivo.
Verificamos arranque, almacenamiento, servicios, permisos, aplicaciones y tareas de backup. Cuando la intervención afectó al RAID o a un hipervisor, los indicadores de salud y la restauración de prueba merecen especial atención.
El cierre debe distinguir lo resuelto de lo pendiente: componentes con vida útil limitada, capacidad insuficiente, alertas, actualizaciones y recomendaciones de mantenimiento preventivo. No ofrecemos disponibilidad absoluta; proponemos medidas proporcionadas al entorno.
Preguntas frecuentes
¿Debemos reiniciar un servidor que muestra errores de disco?
No de forma automática. Si hay alertas de RAID, unidades inestables o datos inaccesibles, reiniciar repetidamente o forzar reconstrucciones puede empeorar la situación. Conviene registrar los mensajes y valorar el estado del almacenamiento y las copias antes de actuar.
¿Un RAID degradado puede seguir funcionando?
En algunos niveles RAID sí, pero disminuye la tolerancia a nuevos fallos. Hay que identificar qué unidad falla, confirmar la topología y valorar el estado de los demás discos antes de reconstruir. La intervención depende del sistema y de los riesgos.
¿RAID y snapshots sustituyen una copia de seguridad?
No. RAID protege frente a determinadas averías de hardware y los snapshots ofrecen puntos de recuperación dentro del mismo entorno, pero ambos pueden quedar afectados por borrados, ransomware, corrupción o fallos del sistema. Se necesitan copias independientes.
¿Se puede reparar un servidor sin reinstalar Windows Server o Linux?
Muchas incidencias se resuelven sin reinstalación, por ejemplo, sustituyendo hardware o reparando servicios. Si existe corrupción grave o daños irreversibles, puede ser necesaria una restauración o migración. Se decide tras diagnosticar.
¿Reparáis entornos virtualizados y máquinas virtuales?
Revisamos incidencias de host, almacenamiento y máquinas virtuales según la plataforma y el acceso autorizado. Antes de intervenir documentamos snapshots, discos virtuales, copias y dependencias para reducir el riesgo de pérdida de información.
¿Qué información conviene facilitar antes de la intervención?
Marca y modelo, rol del servidor, mensajes de error, cambios recientes, servicios afectados, configuración RAID si se conoce y estado de las copias. No envíes contraseñas por formularios públicos; acordaremos un canal seguro si son necesarias.
¿Se puede recuperar la actividad aunque el servidor tarde en repararse?
Depende de las copias, licencias, servicios y recursos disponibles. En algunos casos puede prepararse un equipo temporal, una restauración parcial o una migración planificada, pero es necesario evaluar compatibilidades y tiempos antes de prometer continuidad.
¿Qué comprobaciones se realizan antes de cerrar la reparación?
Se verifican arranque, usuarios, permisos, aplicaciones, conectividad, almacenamiento, alertas y tareas de copia relevantes. El resultado debe explicar qué ha quedado reparado y qué riesgos o trabajos pendientes permanecen.
Planificar una reparación con servicios dependientes
Identificar qué debe recuperarse primero
Un servidor puede sostener archivos, autenticación, máquinas virtuales o una aplicación de gestión. Se identifica qué usuarios dependen de cada servicio y qué copias están disponibles. Antes de reiniciar repetidamente se revisan registros, alertas y estado del almacenamiento, porque una acción rutinaria puede complicar un volumen degradado.
Hardware y almacenamiento
Se comprueban alimentación, memoria, refrigeración, controladora y unidades respetando la configuración existente. En RAID se documentan discos y estado antes de cualquier reconstrucción; si hay varios soportes inestables se valora recuperación de datos. Cambiar una controladora exige compatibilidad y conocimiento de la estructura, no solo igualdad de conectores.
Retorno controlado al servicio
Tras resolver la avería se comprueban aplicaciones, permisos, red y tareas programadas. También se revisa que las copias vuelvan a ejecutarse y que las alertas lleguen al responsable. La intervención se programa con una ventana y prioridades acordadas, y las dependencias externas o pruebas pendientes se documentan para evitar una falsa sensación de normalidad.
¿Necesitas reparar un servidor en Málaga?
Si un servidor ha dejado de prestar servicio, indícanos qué aplicaciones están afectadas, los mensajes de error y el estado de las copias. Valoraremos el diagnóstico antes de efectuar cambios de riesgo.